El 20 de octubre de 2026, en la PyTorch Conference, Google anunció que TorchTPU pasa a ser código abierto. Es la forma nativa de correr PyTorch en las TPU, los chips para IA que Google ofrece en su nube. Lo desarrolló junto con el equipo de PyTorch de Meta, y el código está en GitHub, en google-pytorch/torch_tpu.
Qué cambia en el código
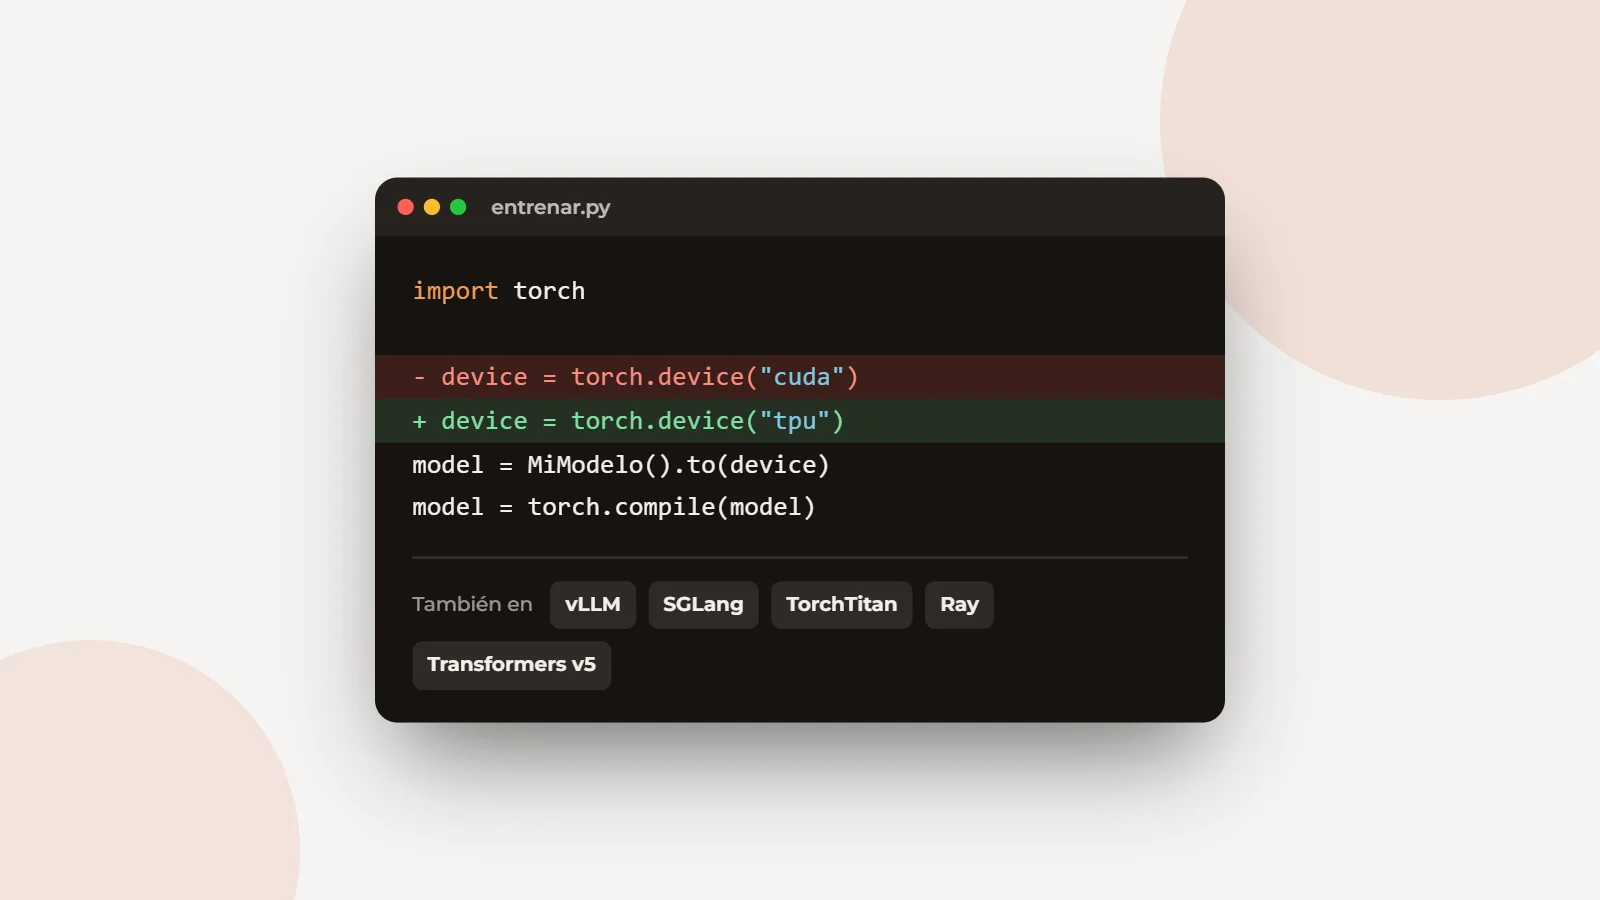
Hasta ahora, la vía para usar PyTorch en TPU era PyTorch/XLA, que tenía sus propias reglas y obligaba a adaptar bastante el código. TorchTPU suma la TPU como un dispositivo más de PyTorch, al lado de la GPU y la CPU. Para un script de entrenamiento, el cambio principal es la inicialización del dispositivo:
pythonimport torch

device = torch.device("tpu")      # antes: torch.device("cuda")
model = MiModelo().to(device)
model = torch.compile(model)       # para rendimiento de producción
El modo inmediato (eager) sirve para depurar, y torch.compile captura el grafo y lo compila para la TPU cuando se busca rendimiento. En Hugging Face Transformers v5 alcanza con pasar device_map="tpu" al cargar un modelo.
Lo que trae
- Entrenamiento distribuido con las primitivas nativas de PyTorch.
- Escala: Google dice haber validado TorchTitan en hasta 8.000 TPU Ironwood (v7x), con escalado casi lineal hasta 8.192 chips.
- Servir modelos con vLLM y SGLang, que ya tienen backends para TorchTPU, y con llm-d.
- Ecosistema: TorchTitan, Ray, VeRL para aprendizaje por refuerzo, TorchRec, Hugging Face Transformers y Diffusers.
- Una suite de agentes en vista previa para ayudar con la migración, el diagnóstico y el ajuste de rendimiento.
Google recomienda empezar los proyectos nuevos con TorchTPU y migrar los que usan PyTorch/XLA. Un límite conocido, según el propio equipo: todavía no soporta la abstracción torch.Stream, lo que afecta algunas combinaciones avanzadas de entrenamiento distribuido.
No podemos depender de una sola arquitectura de hardware. TorchTPU nos permite llevar nuestras cargas de PyTorch a las TPU de Google.
Por qué importa
La mayor parte de la IA moderna se escribe en PyTorch, y PyTorch históricamente funcionó mejor en GPU de Nvidia. Google se suma a Amazon, que tiene un backend similar para sus chips Trainium, en el intento de que cambiar de hardware sea cambiar una línea y no reescribir el proyecto. Google no publicó comparaciones de rendimiento con el lanzamiento.
Qué significa para tu negocio
Para una pyme que usa modelos por API, el efecto es indirecto pero real: más competencia en hardware empuja hacia abajo el costo de entrenar y servir modelos, y eso termina en los precios por consulta. Para equipos que entrenan o ajustan modelos propios, abre una alternativa concreta a la GPU con el mismo código.